Кодировка текста: UTF-8, Unicode, ASCII и кракозябры
Понятное объяснение кодировок текста: как символы превращаются в байты, чем Unicode отличается от UTF-8, почему возникают кракозябры и как это исправить.
Модуль 02: Типы данных и работа со строками
Потренируйтесь работать со строками и кодировками на практике в браузере.
Мы видим на экране букву Я, эмодзи 😀 или слово Привет. Для компьютера это не рисунки и не буквы — в конечном счёте это последовательности чисел и байтов.
Чтобы одна программа записала текст, а другая смогла прочитать его тем же способом, им нужно договориться о правилах представления символов. Именно здесь появляются Unicode, UTF-8, ASCII и другие кодировки. Если правила записи и чтения не совпадают, вместо нормального текста возникает знаменитое Привет. Разберёмся, что происходит с текстом от клавиатуры до памяти и почему UTF-8 сегодня правит интернетом.
1. Что такое кодировка простыми словами
Кодировка определяет, как представить текст в виде данных, которые может хранить, обрабатывать и передавать компьютер.
Представим городскую библиотеку. На полке стоит конкретная книга, а в едином каталоге ей присвоен уникальный шифр (номер). Если два библиотекаря пользуются одной системой каталогизации, первому достаточно передать номер — второй безошибочно поймёт, о какой книге идёт речь.
С текстом ситуация абсолютно идентичная. Есть символ A — у него одно числовое представление. Есть Я — у него другое. Есть эмодзи 😀 — у него третье.
Ключевое правило:
Компьютеры оперируют только битами (0 и 1), сгруппированными в байты (по 8 бит). Чтобы буквы превратились в файлы на диске или сетевые пакеты, человечеству понадобились строгие правила сопоставления каждого символа с последовательностью чисел.
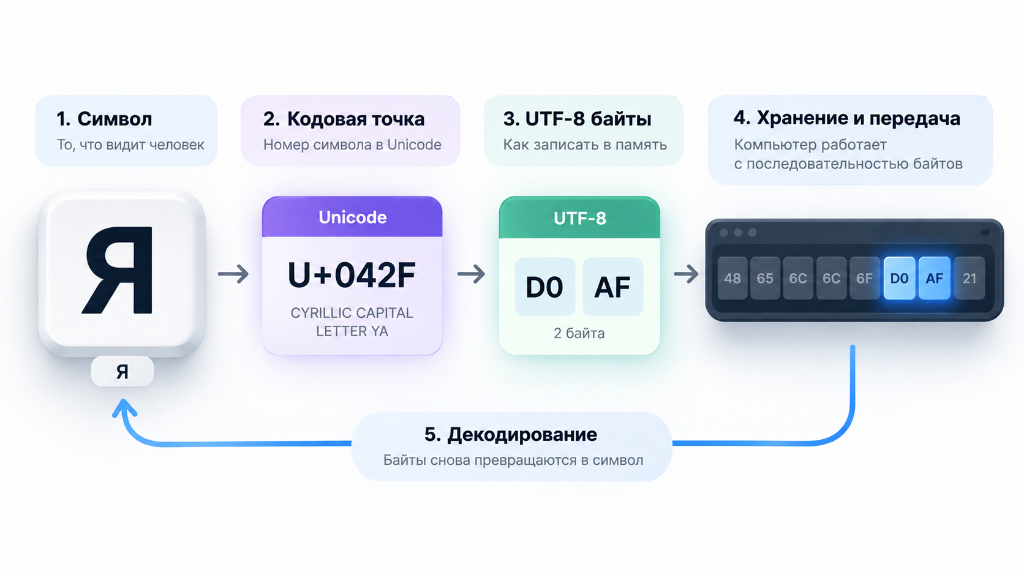
2. Символ, кодовая точка и байты — три разных вещи
Самая частая путаница у начинающих разработчиков — думать, что «Unicode — это и есть UTF-8». Это фундаментальное заблуждение. Между символом, его номером и байтами в памяти есть строгое разделение:
| Символ | Кодовая точка Unicode | UTF-8 в Hex | Размер UTF-8 | Что это означает |
|---|---|---|---|---|
| A | U+0041 | 41 | 1 байт | Латинская буква из ASCII |
| Я | U+042F | D0 AF | 2 байта | Кириллическая буква |
| 😀 | U+1F600 | F0 9F 98 80 | 4 байта | Эмодзи высокого диапазона |
Здесь чётко прослеживаются три самостоятельных шага:
- Символ (Glyph / Character) — то, что видит человек (буква «Я»).
- Кодовая точка Unicode (Code Point) — уникальный международный порядковый номер, присвоенный этому символу (
U+042F). - Байты в UTF-8 — конкретная физическая запись этого номера в бинарном виде (шестнадцатеричные числа
D0 AF).
3. Чем Unicode отличается от UTF-8
- Стандарт Unicode (Каталог символов): Отвечает на вопрос «Какой абстрактный номер соответствует символу?». Unicode — это гигантская таблица более чем из 149 000 символов всех языков мира, символов и пиктограмм. Но он сам по себе не говорит, как эти числа хранить в файле.
- Формат UTF-8 (Упаковка номеров в байты): Отвечает на вопрос «Как записать номер из каталога последовательностью байтов?». Один и тот же Unicode-каталог можно упаковать разными способами: UTF-8, UTF-16 или UTF-32.
Поэтому говорить «текст закодирован в Unicode» технически неграмотно: текст соответствует стандартам Unicode, но закодирован именно в UTF-8.
4. Зачем тогда нужен ASCII
До появления Unicode на заре компьютерной эры использовалась небольшая таблица символов — ASCII (American Standard Code for Information Interchange). Она была создана в 1963 году и содержала всего 128 позиций (от 0 до 127), помещавшихся в 7 бит одного байта:
- Латинские буквы
A-Zиa-z - Цифры от
0до9 - Знаки препинания и базовые символы (
!,?,@,#,$,%)\n- Служебные управляющие символы (перевод строки\n, возврат каретки\r, табуляция\t)
Например, латинская буква A имеет в ASCII код 65 (в шестнадцатеричной системе: 0x41).
Секрет успеха UTF-8:
Гениальность Кена Томпсона и Роба Пайка (создателей UTF-8) заключалась в том, что первые 128 кодов UTF-8 побайтово на 100% совпадают с ASCII. Любой файл, написанный на чистом ASCII (например, исходный код на C, HTML-разметка, JSON-ключи), уже является валидным UTF-8 файлом.
5. Как UTF-8 хранит разные символы
Главная особенность UTF-8 — это переменная длина (variable-length encoding). В зависимости от порядкового номера символа в таблице Unicode он занимает от 1 до 4 байтов:
- 1 байт (0..127): ASCII (латиница A-Z, цифры 0-9, теги HTML)
- 2 байта (128..2047): Кириллица (русский, греческий, арабский)
- 3 байта (2048..65535): CJK / Символы (китайский, японский, знаки вроде €)
- 4 байта (65536..1114111): Эмодзи (😀, 🚀, редкие исторические символы)
Это обеспечивает идеальный баланс: веб-страницы на латинице не раздуваются в объёме, а интернациональный контент передаётся без потерь.
6. Что такое кракозябры (mojibake) и почему они появляются
Кракозябры возникают не потому, что компьютер «сломался» или «не знает русских букв».
Анатомия сбоя:
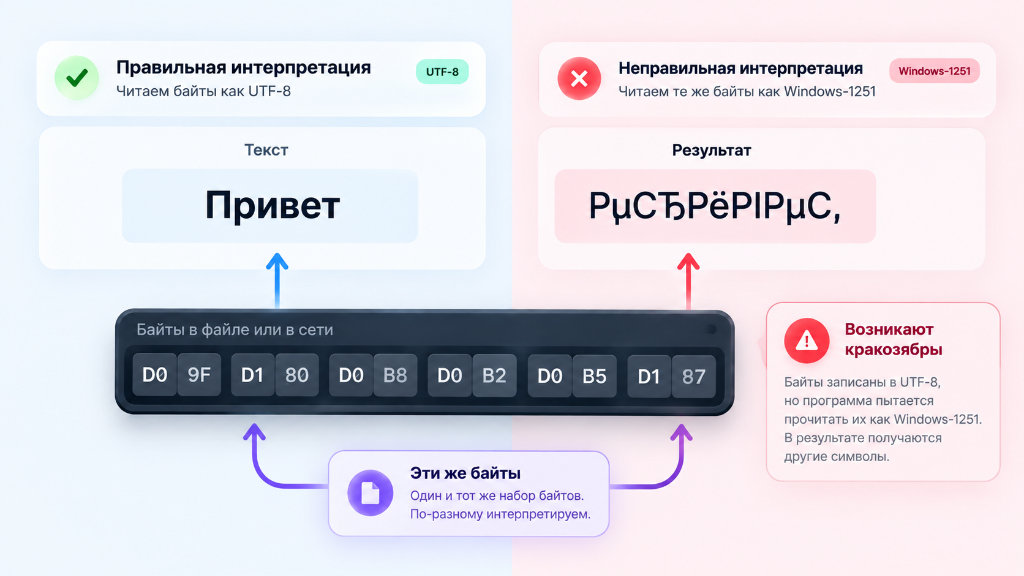
Текст записали одними байтами по правилам одной кодировки (например, UTF-8), а программа попыталась прочитать и сопоставить эти же байты по правилам другой кодировки (например, Windows-1251 или KOI8-R).
В слове «Привет» первая буква «П» в UTF-8 кодируется двумя байтами: 0xD0 и 0x9F. Если старая программа для Windows откроет этот файл и решит, что перед ней однобайтовая кодировка Windows-1251, она прочитает:
- байт
0xD0по таблице Windows-1251 равен русской букве «Р» - байт
0x9Fпо таблице Windows-1251 равен знаку «џ»
Так вместо одной буквы «П» на экране появляются две: Рџ. А всё слово превращается в Привет. Сами байты в файле целы и невредимы — ошиблась исключительно программа, выбравшая не ту кодовую страницу.
7. Откуда берутся ошибки кодировки на практике
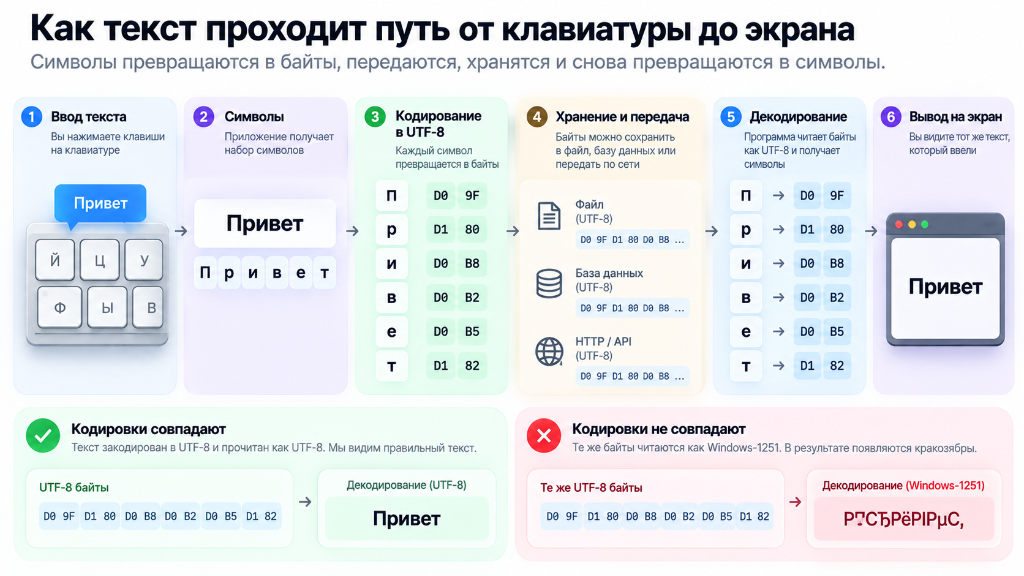
В современном веб-приложении текст проходит сложную производственную цепочку:
Браузер → Сеть / HTTP → Node.js / Python API → База данных (PostgreSQL / MySQL) → Экспорт в CSV → Excel
Ошибка на любом из этих стыков ломает текст:
- Конфликт HTML и сервера: файл сохранён в UTF-8, но веб-сервер Nginx отправляет заголовок
Content-Type: text/html; charset=windows-1251. - База данных в latin1: таблица MySQL создана с кодировкой
latin1, и кириллические байты превратились в невосстановимый знак замены (replacement character). - Импорт в Excel: CSV-файл выгружен в UTF-8 без BOM, а Microsoft Excel на Windows автоматически открывает его в кодировке Windows-1251.
- CLI и терминалы: скрипт выводит лог в консоль сервера, где переменная окружения
LANGнастроена наPOSIXвместоen_US.UTF-8.
8. Как браузер узнаёт кодировку страницы
Браузер соблюдает строгий приоритет источников метаданных:
- HTTP-заголовок ответа (высший приоритет):
Content-Type: text/html; charset=utf-8 - Тег meta в самом начале
<head>:<meta charset="UTF-8"> - Байтовый маркер последовательности (BOM):
специальные байты0xEF, 0xBB, 0xBFв начале файла.
Золотое правило фронтенд-инженера:
Тег<meta charset="UTF-8">всегда должен идти первой строкой внутри блока<head>, до тега<title>и любых внешних скриптов. Иначе браузер успеет прочитать заголовок вкладки до того, как узнает правила расшифровки байтов.
9. Как посмотреть UTF-8 байты прямо в JavaScript
В браузере и Node.js есть встроенный класс TextEncoder, умеющий переводить строковые символы в массив байтов Uint8Array:
const encoder = new TextEncoder();

// 1. Латинская буква A (1 байт)
console.log(encoder.encode('A'));
// => Uint8Array [ 65 ] (в hex: 0x41)

// 2. Русская буква Я (2 байта)
console.log(encoder.encode('Я'));
// => Uint8Array [ 208, 175 ] (в hex: 0xD0, 0xAF)

// 3. Эмодзи 😀 (4 байта)
console.log(encoder.encode('😀'));
// => Uint8Array [ 240, 159, 152, 128 ] (в hex: 0xF0, 0x9F, 0x98, 0x80)
А для обратной операции декодирования используется класс TextDecoder:
const decoder = new TextDecoder('utf-8');
const bytes = new Uint8Array([0xD0, 0xAF]);

console.log(decoder.decode(bytes));
// => 'Я'
⚡ Интерактивный онлайн-инспектор UTF-8 байтов и симулятор кракозябр
Попробуйте ввести собственный текст, эмодзи или спецсимволы ниже. Инструмент в реальном времени разложит каждый символ на кодовую точку Unicode и шестнадцатеричные байты UTF-8, а также покажет живую симуляцию появления кракозябр при чтении в Windows-1251:
Инспектор байтов UTF-8 и генератор кракозябр
| Символ | Unicode Code Point | UTF-8 Байты (Hex) | Размер |
|---|---|---|---|
| П | U+041F(1055) | 0xD00x9F | 2 байта |
| р | U+0440(1088) | 0xD10x80 | 2 байта |
| и | U+0438(1080) | 0xD00xB8 | 2 байта |
| в | U+0432(1074) | 0xD00xB2 | 2 байта |
| е | U+0435(1077) | 0xD00xB5 | 2 байта |
| т | U+0442(1090) | 0xD10x82 | 2 байта |
| ␣ (пробел) | U+0020(32) | 0x20 | 1 байт |
| 😀 | U+1F600(128512) | 0xF00x9F0x980x80 | 4 байта |
Расчёт выполняется в реальном времени с помощью встроенного браузерного API TextEncoder без отправки данных на сервер.
10. UTF-8, UTF-16 и UTF-32 — в чём разница
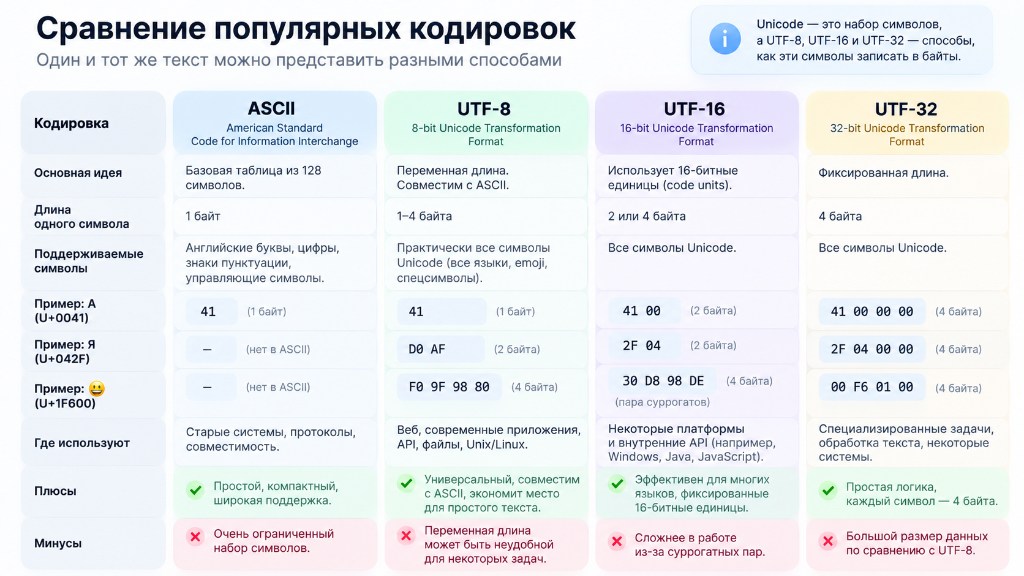
Все три формата кодирования способны представить любой символ Unicode без исключений, но делают это с разной архитектурной философией:
| Кодировка | Длина символа | Где применяется | Плюсы | Минусы |
|---|---|---|---|---|
| UTF-8 | 1–4 байта | Веб, HTTP, JSON, БД, Linux | Совместим с ASCII, компактен для латиницы | Переменная длина усложняет доступ по индексу |
| UTF-16 | 2 или 4 байта | Память JavaScript (V8), JVM, Windows API | Эффективен для азиатских языков (CJK) | Сложность с суррогатными парами для эмодзи |
| UTF-32 | Ровно 4 байта | Математические и лингвистические движки | Фиксированная длина: 1 символ = 4 байта | Избыточный размер файлов (в 4 раза больше) |
11. Как исправлять кракозябры: пошаговый алгоритм
Если вы столкнулись с кракозябрами на продакшене, главное правило — не сохраняйте повреждённый файл поверх оригинала! Если испорченный текст повторно перезаписать, байты могут быть безвозвратно утеряны.
- Проверьте веб-страницу:
Вкладка DevTools → Network → проверьте заголовокContent-Type: text/html; charset=utf-8. Убедитесь, что<meta charset="UTF-8">стоит на первой позиции в<head>. - Проверьте CSV-файл или выгрузку из Excel:
В Excel используйте: Данные → Получить данные → Из текстового/CSV-файла и в выпадающем меню явно укажите кодировку 65001: Юникод (UTF-8). - Проверьте подключение к базе данных:
Убедитесь, что совпадают три параметра: кодировка самой базы (utf8mb4в MySQL илиUTF8в PostgreSQL), кодировка соединения клиента и кодировка строк в коде приложения. - Проверьте перекодировщик в IDE:
В VS Code в правом нижнем углу кликните по названию кодировки → «Reopen with Encoding» (перебирайте Windows-1251, CP866 или UTF-8) → затем «Save with Encoding → UTF-8».
12. Можно ли автоматически определить кодировку файла?
С вероятностью 95–99% — да, с гарантией 100% — нет.
Сам по себе поток байтов в файле не содержит метаданных «я записан в Windows-1251». Библиотеки вроде chardet или jschardet используют статистический анализ: частоту встречаемости характерных биграмм, триграмм и валидность старших битов UTF-8. Но для коротких строк детектор может ошибиться.
Надёжная разработка строится не на угадывании кодировки, а на явном согласовании метаданных (заголовки, мета-теги, настройки соединений).
13. Частые вопросы (FAQ)
Unicode и UTF-8 — это одно и то же?
Нет. Unicode — это международный каталог, присваивающий каждому символу мира персональный номер (кодовую точку). UTF-8 — это конкретный алгоритм упаковки этих номеров в байты для хранения и передачи по сети.
Что лучше использовать на сайте в 2026 году?
Исключительно UTF-8 на всех участках: в файлах HTML, API-ответах JSON, заголовках HTTP, кодировке баз данных и конфигурации сборщиков. Это международный стандарт современного веба.
Почему русская буква занимает в UTF-8 два байта, а латинская — один?
UTF-8 использует переменную длину. Первые 128 символов зарезервированы под таблицу ASCII (латиница) для обратной совместимости и занимают 1 байт. Русские буквы имеют кодовые точки в диапазоне от U+0400 до U+04FF и по спецификации кодируются ровно двумя байтами.
Что означает запись U+1F600?
Это стандартная нотация кодовой точки Unicode в шестнадцатеричном виде. Число 1F600 соответствует порядковому номеру 128512 в каталоге символов и закреплено за эмодзи 😀 (Grinning Face).
Почему вместо текста появляется символ чёрного ромба с вопросом?
Это официальный символ замены Unicode (Replacement Character, U+FFFD). Браузер или декодер показывает его, когда встречает бинарную последовательность байтов, не соответствующую спецификации UTF-8 (например, оборванный байт или байты, недопустимые в UTF-8).
14. Коротко о главном (Шпаргалка)
- Кодировка превращает текст в понятные компьютеру байты.
- Unicode даёт каждому символу уникальный международный номер (Code Point).
- ASCII — базовый исторический набор из 128 символов, совместимость с которым сохранил UTF-8.
- UTF-8 кодирует символы последовательностями от 1 до 4 байтов и является стандартом веба.
- Кракозябры — это не поломка компьютера, а чтение байтов одной кодировки по правилам другой.
Формула надежной работы:
Символ → Unicode Code Point → UTF-8 байты → Передача → Декодирование → Символ.
Понравилась шпаргалка?
В платформе CopyPastWorld собрано более 400 интерактивных уроков с практическими заданиями, автотестами и поддержкой сообщества.